اختلال سهساعته AWS دسترسی به چندین سرویس ابری را مختل کرد
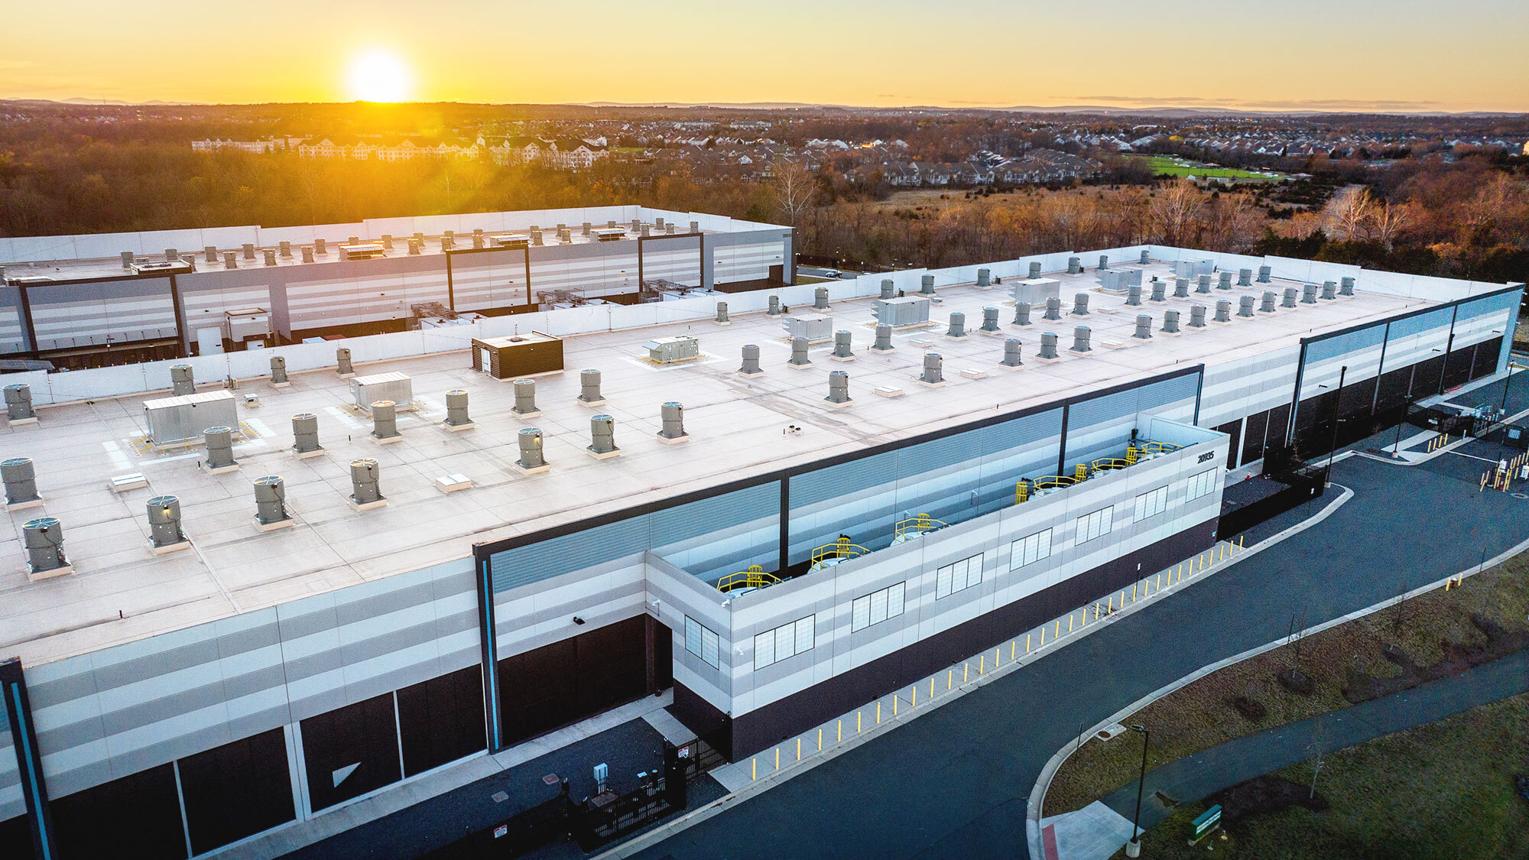
خدمات ابری آمازون روز یکشنبه ۱۵ نوامبر ۲۰۲۶ با اختلالی در منطقه ویرجینیای شمالی آمریکا روبهرو شدند که باعث بروز مشکلات ارتباطی، اختلال در ورود کاربران و خطا هنگام ثبتنام حسابهای جدید شد. این مشکل علاوه بر سامانه مدیریت هویت AWS، بعضی سرویسهای وابسته از جمله Amazon Connect و ابزار توسعه نرمافزار Kiro را تحت تأثیر قرار داد. آمازون پس از چند ساعت بررسی و اجرای اقدامات اصلاحی اعلام کرد که خدمات به وضعیت عادی بازگشتهاند.
بر اساس گزارش رسمی Amazon Web Services، مشکلات از ساعت ۳:۰۵ بامداد به وقت استاندارد اقیانوس آرام آمریکا آغاز شد و بخش عمده آنها تا ساعت ۶:۱۰ برطرف شد. بااینحال، یک مشکل محدودتر در بخشی از زیرساخت توزیع ترافیک شبکه تا ساعت ۶:۲۱ ادامه داشت. آمازون در آخرین اطلاعیه خود، ساعت ۶:۵۳ صبح همان روز، پایان اختلال را تأیید کرد.
این اتفاق در منطقه US-EAST-1 رخ داد؛ یکی از مهمترین مناطق زیرساخت ابری AWS که در ویرجینیای شمالی قرار دارد و شمار زیادی از برنامهها و خدمات اینترنتی از امکانات آن استفاده میکنند.
با وجود گستردگی فهرست سرویسهای درگیر، آمازون تعداد دقیق مشتریان آسیبدیده یا میزان خسارت اقتصادی ناشی از این رویداد را اعلام نکرده است. همچنین در اطلاعیه نهایی، علت ریشهای اختلال بهطور مشخص توضیح داده نشده و شواهد منتشرشده نیز دلیلی برای نسبت دادن آن به حمله سایبری ارائه نمیکنند.
مشکل از کجا آغاز شد؟
نخستین گزارش عمومی AWS درباره این رخداد ساعت ۴:۳۸ صبح به وقت PST منتشر شد. شرکت در آن زمان اعلام کرد گزارشهایی از مشکلات ارتباطی در منطقه US-EAST-1 دریافت کرده و بررسی موضوع را آغاز کرده است.
در همان اطلاعیه اولیه مشخص شد که اختلال تنها به ارتباطات شبکه محدود نیست و درخواستهای ورود از طریق IAM Identity Center و فرایند ثبتنام کاربران جدید نیز با مشکل روبهرو شدهاند.
البته اطلاعیه اولیه زمانی منتشر شد که اختلال از مدتی قبل آغاز شده بود. گزارش نهایی آمازون زمان شروع اثر واقعی بر مشتریان را ساعت ۳:۰۵ صبح اعلام میکند.
پنج دقیقه پس از آغاز مشکل، یعنی ساعت ۳:۱۰، مهندسان شرکت بهصورت خودکار برای بررسی وضعیت فراخوانده شدند. آمازون گفته است که تیمهای فنی همزمان دو مسیر را دنبال میکردند: شناسایی علت اختلال و اجرای اقدامات لازم برای کاهش اثر آن بر خدمات.
در ساعت ۵:۱۵، شرکت جزئیات بیشتری منتشر کرد و توضیح داد که خطاهای احراز هویت بر سرویسهایی اثر گذاشتهاند که برای ورود کاربران به IAM Identity Center وابسته هستند.
تا آن زمان، راهکار جایگزین عمومی برای کاربران آسیبدیده اعلام نشده بود.
اندکی بعد، نشانههای اولیه بازیابی ظاهر شد. AWS ساعت ۵:۲۲ اعلام کرد که وضعیت ثبتنام و احراز هویت در حال بهبود است. طبق گزارش نهایی، مشکل اصلی احراز هویت ساعت ۵:۲۰ مهار شده بود و بخش عمده خدمات نیز در همان زمان بازیابی شدند.
اما اختلال به همین نقطه ختم نشد و بخشی محدود از تجهیزات توزیع ترافیک همچنان به اقدامات اصلاحی نیاز داشت.
سامانه ورود کاربران یکی از بخشهای اصلی اختلال بود
یکی از مهمترین سرویسهای درگیر، AWS IAM Identity Center بود.
این سامانه به سازمانها کمک میکند دسترسی کارکنان و کاربران مجاز را به حسابها، برنامهها و منابع ابری مدیریت کنند. بهجای آنکه هر شخص برای هر سرویس نام کاربری و رمز عبور جداگانه داشته باشد، سازمان میتواند بخش مهمی از فرایند ورود و کنترل دسترسی را بهصورت متمرکز مدیریت کند.
این روش در شرکتهای بزرگ اهمیت ویژهای دارد، زیرا تعداد کاربران، حسابهای ابری و سطح دسترسی افراد ممکن است بسیار زیاد باشد.
فرض کنید شرکتی صدها کارمند دارد که برای انجام وظایف روزانه از برنامههای مختلف AWS استفاده میکنند. اگر ورود آنها به این برنامهها به یک سامانه مشترک احراز هویت وابسته باشد، اختلال در همان بخش میتواند دسترسی به چند سرویس را بهصورت همزمان دشوار کند.
در چنین شرایطی، برنامه موردنظر ممکن است همچنان فعال باشد، اما کاربر نتواند هویت خود را تأیید کند یا نشست جدیدی ایجاد کند.
این تفاوت اهمیت دارد؛ زیرا خطای ورود الزاماً به معنای ازکارافتادن کامل پردازندهها، پایگاههای داده یا همه اجزای یک سرویس نیست.
AWS در گزارش حادثه توضیح داده است که کاربران وابسته به IAM Identity Center ممکن بود هنگام ورود به کنسول مدیریتی AWS یا سرویسهای دیگری مانند Kiro و Amazon Connect با مشکل روبهرو شوند.
بنابراین بخشی از پیامدهای حادثه از وابستگی خدمات مختلف به زیرساخت مشترک مدیریت هویت ناشی شده است.
Kiro و Amazon Connect چگونه تحت تأثیر قرار گرفتند؟
Kiro از ابزارهای توسعه نرمافزار AWS است که برای کمک به برنامهنویسان در فرایند طراحی و تولید کد استفاده میشود.
طبق اطلاعیه رسمی، مشکل احراز هویت میتوانست ورود بعضی کاربران Kiro را مختل کند. بااینحال، آمازون مشخص کرد که ورود از طریق روشهای اجتماعی یا Social Sign-in برای کاربران این سرویس تحت تأثیر قرار نگرفته بود.
این جزئیات نشان میدهد اثر اختلال برای تمام کاربران یک محصول یکسان نبوده است.
کاربری که از یک روش احراز هویت استفاده میکرد ممکن بود با خطا مواجه شود، در حالی که کاربر دیگری از مسیر ورود متفاوت همچنان امکان دسترسی داشته باشد.
Amazon Connect نیز یکی دیگر از سرویسهای درگیر بود. این محصول برای راهاندازی و مدیریت مراکز تماس و ارتباط با مشتریان به کار میرود.
اختلال در ورود مدیران یا کارکنان یک مرکز تماس میتواند بر فعالیتهای عملیاتی تأثیر بگذارد، اما اطلاعات منتشرشده مشخص نمیکند چه تعداد مرکز تماس دچار مشکل شدهاند یا کدام قابلیتها در هر سازمان مختل بودهاند.
بنابراین نمیتوان از فهرست رسمی سرویسهای آسیبدیده نتیجه گرفت که تمام تماسهای مشتریان در همه مراکز مبتنی بر Amazon Connect قطع شده است.
به همین ترتیب، اعلام درگیری Kiro به معنای توقف کامل فعالیت تمام برنامهنویسان استفادهکننده از این ابزار نیست.
گزارش AWS صرفاً وجود مشکل در بخشهایی از خدمات و مسیرهای دسترسی را تأیید میکند.
اختلال در توزیعکنندههای بار شبکه ادامه پیدا کرد
پس از برطرف شدن بخش عمده مشکلات احراز هویت، یک مسئله شبکهای محدودتر همچنان باقی مانده بود.
آمازون در ساعت ۶:۲۳ صبح اعلام کرد که بیشتر خدمات بازیابی شدهاند، اما بخشی از مشتریانی که از Network Load Balancer یا NLB استفاده میکنند هنوز با اختلال ارتباطی مواجه هستند.
Network Load Balancer یکی از سرویسهای AWS برای توزیع ترافیک ورودی میان چند سرور یا مقصد پردازشی است.
برای مثال، یک فروشگاه اینترنتی بزرگ ممکن است بهجای استفاده از تنها یک سرور، درخواستهای کاربران را میان چندین سرور تقسیم کند. این روش امکان مدیریت ترافیک بیشتر و افزایش پایداری سامانه را فراهم میکند.
توزیعکننده بار نقش واسطه را دارد. درخواستهای کاربران ابتدا به آن میرسند و سپس به مقصدهای مناسب منتقل میشوند.
اگر بخشی از این زیرساخت دچار مشکل شود، ممکن است درخواستهای کاربران با خطای ارتباطی یا تأخیر روبهرو شوند، حتی اگر خود سرورهای مقصد همچنان فعال باشند.
در حادثه ۱۵ نوامبر، AWS مشخص کرد که مشکل باقیمانده به تعدادی از Network Load Balancerها در یک سلول از یک منطقه دسترسپذیری با شناسه use1-az1 مربوط است.
این توضیح اهمیت زیادی دارد؛ زیرا نشان میدهد مشکل نهایی تمام زیرساخت توزیع بار AWS را در بر نگرفته بود.
شرکت در آن مرحله به مشتریانی که نیاز فوری به بازیابی داشتند پیشنهاد کرد یک Network Load Balancer جدید با مقصدهایی در چند منطقه دسترسپذیری ایجاد کنند.
این پیشنهاد برای همان شرایط خاص مطرح شد و به معنای ضرورت انجام چنین تغییری برای تمام مشتریان AWS نبود.
چرا چند منطقه دسترسپذیری اهمیت دارند؟
معماری AWS بر اساس تقسیم زیرساخت جهانی به مناطق جغرافیایی یا Region و مناطق دسترسپذیری یا Availability Zone طراحی شده است.
هر Region میتواند چند Availability Zone داشته باشد که از نظر زیرساخت فیزیکی و برخی وابستگیهای عملیاتی از یکدیگر جدا شدهاند.
هدف از این طراحی، کاهش احتمال آن است که خرابی یک بخش فیزیکی باعث ازکارافتادن تمام سامانههای یک مشتری شود.
منطقه US-EAST-1 در ویرجینیای شمالی قرار دارد و شامل چندین منطقه دسترسپذیری است.
سازمانها میتوانند سرویسهای خود را به شکلی پیکربندی کنند که در چند Availability Zone مستقر باشند. در این صورت، اگر یکی از مناطق با مشکل روبهرو شود، در شرایط مناسب ممکن است بخش دیگری از زیرساخت به فعالیت ادامه دهد.
اما این قابلیت به معماری برنامه و تنظیمات مشتری وابسته است.
صرف استفاده از AWS به این معنا نیست که یک برنامه بهصورت خودکار در برابر خرابی تمام اجزای زیرساخت مقاوم خواهد بود.
اگر یک شرکت تمام منابع حیاتی خود را در یک منطقه یا یک مسیر دسترسی متمرکز کرده باشد، ممکن است آسیبپذیری بیشتری داشته باشد.
در حادثه اخیر نیز توصیه AWS درباره استفاده از مقصدهای مستقر در چند Availability Zone نشان میداد که توزیع مناسب منابع میتواند در بعضی شرایط به کاهش پیامد اختلال کمک کند.
البته حتی معماری چندمنطقهای نیز تضمین مطلق در برابر تمام خرابیها نیست. سرویسهای مشترک، خطاهای پیکربندی و وابستگیهای نرمافزاری ممکن است همچنان مشکلاتی ایجاد کنند.
یازده سرویس AWS در فهرست اختلال قرار گرفتند
داشبورد رسمی سلامت AWS فهرستی از یازده سرویس را منتشر کرد که در ارتباط با این حادثه وضعیت آسیبدیده و سپس بازیابیشده داشتند.
این فهرست شامل AWS IAM Identity Center، AWS IoT Device Management، AWS NAT Gateway و AWS Sign Up بود.
همچنین AWS Step Functions، Amazon CloudWatch، Amazon Connect و Amazon Elastic Load Balancing در میان خدمات ثبتشده قرار داشتند.
سه سرویس دیگر، Amazon OpenSearch Service، Amazon VPC Lattice و Kiro بودند.
این خدمات کاربردهای متفاوتی دارند. CloudWatch برای پایش و مشاهده وضعیت زیرساخت و برنامهها استفاده میشود و Step Functions به هماهنگی مراحل گردشکارهای نرمافزاری کمک میکند.
OpenSearch Service نیز برای جستوجو و تحلیل داده کاربرد دارد. NAT Gateway و VPC Lattice در بخشهایی از ارتباطات شبکهای و اتصال سرویسها نقش دارند.
قرار گرفتن این خدمات در فهرست حادثه نشان میدهد مشکل میتوانسته چند بخش متفاوت از فعالیت مشتریان AWS را تحت تأثیر قرار دهد.
بااینحال، درجه اثرگذاری برای هر سرویس و هر مشتری ممکن است متفاوت بوده باشد.
آمازون گزارشی منتشر نکرده که نشان دهد تمام قابلیتهای هر یازده سرویس در تمام مدت حادثه از دسترس خارج شدهاند.
در نتیجه، تعبیر دقیقتر این است که بخشهایی از خدمات مرتبط با این سرویسها در منطقه آسیبدیده با مشکل مواجه شده بودند.
چرا وقوع اختلال در ویرجینیای شمالی مهم است؟
ویرجینیای شمالی یکی از مراکز مهم صنعت مراکز داده در آمریکاست.
مجموعهای از شرکتهای بزرگ فناوری در این منطقه زیرساختهای پردازشی، ذخیرهسازی و ارتباطی دارند و بخش قابلتوجهی از خدمات ابری از امکانات این محدوده جغرافیایی استفاده میکنند.
US-EAST-1 نیز یکی از مناطق قدیمی و پرکاربرد AWS است.
برای بسیاری از شرکتها، منطقه ابری بر اساس عواملی مانند محل کاربران، دسترسی به سرویسهای موردنیاز، تأخیر شبکه و هزینه انجام میشود.
بااینحال، تمرکز منابع در یک منطقه میتواند ریسک مشخصی ایجاد کند: اختلال محلی در همان منطقه ممکن است بر چندین برنامه وابسته اثر بگذارد.
اهمیت حادثه ۱۵ نوامبر نیز تنها به مدت چندساعته آن محدود نیست. این اتفاق دوباره نشان میدهد حتی زیرساختهای بزرگ و پیشرفته نیز ممکن است با اختلال عملیاتی روبهرو شوند.
اما درباره وسعت پیامدهای این حادثه باید احتیاط کرد.
هیچ آمار رسمی از شمار کل وبسایتها، کاربران یا کسبوکارهایی که خدماتشان متوقف شده منتشر نشده است.
بنابراین عبارتهایی مانند توقف بخش بزرگی از اینترنت یا قطع جهانی AWS برای توصیف این رویداد دقیق نیستند.
آنچه گزارش رسمی تأیید میکند، اختلال در بخشی از خدمات منطقه ویرجینیای شمالی و وابستگی برخی محصولات دیگر به همان زیرساخت است.
آیا حمله سایبری عامل اختلال بود؟
تا زمان انتشار گزارش نهایی، AWS علت ریشهای حادثه را بهطور مشخص اعلام نکرده بود.
این موضوع به معنای آن نیست که شرکت هیچ اطلاعاتی درباره علت فنی ندارد، بلکه صرفاً نشان میدهد توضیح عمومی موجود علت نهایی را مشخص نکرده است.
در گزارشهای اولیه و نهایی به مشکلات ارتباطی، احراز هویت و تعدادی از توزیعکنندههای بار شبکه اشاره شده است.
اما هیچیک از این توضیحات بهتنهایی اثبات نمیکند که حمله سایبری، تغییر پیکربندی اشتباه، خرابی سختافزار یا عامل دیگری منشأ اختلال بوده است.
در زیرساختهای ابری، چنین نشانههایی ممکن است از علتهای متفاوتی ناشی شوند.
برای مثال، یک مشکل در سامانه مدیریت هویت میتواند بدون وجود حمله خارجی باعث شود کاربران نتوانند وارد خدمات شوند.
همچنین اختلال در بخشی از شبکه ممکن است به تجهیزات، نرمافزار یا تنظیمات ارتباطی مربوط باشد.
بدون گزارش فنی تکمیلی نمیتوان یکی از این سناریوها را بهعنوان علت قطعی معرفی کرد.
این احتیاط بهویژه در پوشش اخبار امنیت سایبری اهمیت دارد، زیرا هر اختلال فناوری الزاماً نتیجه فعالیت مهاجمان نیست.
در حادثه AWS، اطلاعات رسمی موجود فقط وقوع مشکل و روند بازیابی را تأیید میکند.
خدمات چگونه به وضعیت عادی بازگشتند؟
روند بازیابی حادثه بهصورت مرحلهای انجام شد.
نخست، مهندسان AWS توانستند مشکل احراز هویت را مهار کنند. طبق گزارش رسمی، این مرحله حدود ساعت ۵:۲۰ صبح انجام شد.
در همان زمان، بیشتر سرویسهای AWS نیز نشانههای بازیابی کامل را نشان دادند.
اما مشکل ارتباطی باقیمانده در یک بخش محدود از Network Load Balancerها نیازمند بررسی بیشتر بود.
AWS ساعت ۶:۲۳ صبح اعلام کرد که همچنان مشغول رفع این مشکل است و برای مشتریانی که نیاز فوری به راهکار جایگزین دارند، ایجاد یک NLB جدید در چند Availability Zone را توصیه کرد.
در اطلاعیه بعدی، ساعت ۶:۳۲ صبح، شرکت اعلام کرد نشانههای قابلتوجهی از بازیابی مشاهده میشود و پایش برای تأیید وضعیت نهایی ادامه دارد.
گزارش نهایی میگوید مشکل زیرساختی باقیمانده تا ساعت ۶:۲۱ برطرف شده بود.
در ساعت ۶:۵۳ صبح، AWS اعلام کرد همه سرویسها به وضعیت عادی عملیاتی بازگشتهاند.
ممکن است در سامانههای مستقل پایش، مدت رسمی ثبت حادثه دو ساعت و پانزده دقیقه نمایش داده شود. این عدد به فاصله نخستین اعلام عمومی تا بستهشدن گزارش در سامانه پایش مربوط است.
اما گزارش نهایی AWS بازه بروز اثر واقعی بر خدمات را از ساعت ۳:۰۵ تا ۶:۱۰ صبح توصیف میکند و مشکل محدودتر شبکه را تا ۶:۲۱ ثبت کرده است.
بنابراین این دو نوع زمانبندی نباید با یکدیگر اشتباه گرفته شوند.
این اتفاق چه درسی برای کسبوکارهای اینترنتی دارد؟
اختلال AWS یک نمونه واقعی از وابستگی خدمات اینترنتی به زیرساختهای مشترک است.
بسیاری از کسبوکارها از خدمات ابری استفاده میکنند تا بدون ساخت مرکز داده مستقل، نرمافزارها و سرویسهای خود را اجرا کنند.
این مدل مزایای مهمی دارد؛ از جمله امکان افزایش ظرفیت، دسترسی به خدمات مدیریتی و کاهش بخشی از پیچیدگی اداره سختافزار.
بااینحال، استفاده از ابر به معنی حذف کامل خطر اختلال نیست.
اگر مسیر ورود کاربران به یک سامانه مشترک وابسته باشد، حتی فعال بودن سرورهای اصلی ممکن است برای ادامه فعالیت کافی نباشد.
به همین دلیل، طراحی مناسب برنامه باید علاوه بر پردازش و ذخیرهسازی، وابستگیهای مربوط به احراز هویت، شبکه و مدیریت ترافیک را نیز در نظر بگیرد.
یکی از روشهای کاهش خطر، توزیع منابع حیاتی میان چند منطقه دسترسپذیری است. در بعضی سامانههای حساس نیز استفاده از چند منطقه جغرافیایی میتواند مطرح باشد.
اما چنین معماریهایی هزینه و پیچیدگی بیشتری دارند و همیشه برای یک وبسایت یا برنامه کوچک ضروری نیستند.
راهکار مناسب باید بر اساس اهمیت سرویس، میزان تحمل قطعی و هزینه موردقبول سازمان شود.
داشتن برنامه بازیابی، نظارت مناسب و آگاهی از وابستگیهای فنی نیز میتواند در کاهش پیامدهای حوادث مشابه مؤثر باشد.
آیا کاربران خسارت دیدهاند؟
در گزارش رسمی AWS اطلاعاتی درباره میزان خسارت اقتصادی این حادثه منتشر نشده است.
همچنین مشخص نیست چند مشتری سازمانی برای چه مدت امکان استفاده از خدمات موردنیاز خود را از دست دادهاند.
این موضوع مانع از آن میشود که بتوان درباره خسارت مالی مستقیم یا تعداد کاربران آسیبدیده عدد مشخصی ارائه کرد.
در خدمات ابری، اثر یک اختلال ممکن است از یک سازمان به سازمان دیگر تفاوت زیادی داشته باشد.
برای شرکتی که در زمان حادثه فعالیت کمی داشته، مشکل احراز هویت شاید فقط باعث تأخیر در ورود چند کارمند شده باشد.
اما برای سازمانی که عملیات روزانه آن به سامانه مدیریت هویت یا مسیر شبکهای آسیبدیده وابسته بوده، همان اختلال ممکن است مشکلات عملیاتی مهمتری ایجاد کرده باشد.
حتی پس از رفع مشکل زیرساخت اصلی، ممکن است بعضی برنامهها به تکرار درخواستهای ناموفق یا بررسی وضعیت داخلی خود نیاز داشته باشند.
AWS در اطلاعیه نهایی از مشتریان خواست درخواستهایی را که با خطا مواجه شده بودند دوباره ارسال کنند.
بااینحال، انتشار چنین توصیهای به معنی وجود خسارت قطعی یا از دست رفتن دادهها نیست.
هیچ مدرکی در گزارش رسمی ارائه نشده که نشان دهد اطلاعات مشتریان در این حادثه حذف یا افشا شدهاند.
بازگشت AWS به وضعیت عادی؛ اما علت هنوز روشن نیست
اختلال ۱۵ نوامبر در منطقه ویرجینیای شمالی AWS سرانجام در همان روز مهار شد و آمازون اعلام کرد همه سرویسهای درگیر دوباره بهصورت عادی فعالیت میکنند.
طبق جزئیات رسمی، مشکلات احراز هویت زودتر از مشکل محدود توزیع ترافیک شبکه برطرف شدند و آخرین بخش آسیبدیده نیز تا ساعت ۶:۲۱ صبح به وضعیت عادی بازگشت.
این حادثه با اختلال Microsoft 365 که در روزهای قبل گزارش شده بود، ارتباط اثباتشدهای ندارد. دو رویداد به ارائهدهندگان مختلف مربوطاند و اطلاعات منتشرشده دلیلی برای مشترک دانستن منشأ آنها ارائه نمیکند.
اهمیت خبر تازه AWS بیشتر در نشان دادن وابستگی چند سرویس متفاوت به زیرساختهای مشترک احراز هویت و ارتباطات شبکهای است.
در عین حال، نباید از این رویداد نتیجه گرفت که تمام خدمات AWS در سطح جهان از دسترس خارج شدهاند.
محدوده شناختهشده حادثه منطقه US-EAST-1 بود و بخشی از مشکلات نهایی نیز به تعداد محدودی از مشتریان در یک سلول شبکهای مربوط میشد.
با انتشار گزارش نهایی، زمانبندی حادثه و سرویسهای درگیر روشن شدهاند؛ اما علت ریشهای هنوز در اطلاعیه عمومی مشخص نشده است.
تا زمان انتشار توضیحات فنی بیشتر، دقیقترین ارزیابی این است که AWS با اختلالی چندساعته در بخشی از زیرساخت ابری ویرجینیای شمالی روبهرو شد، توانست خدمات را بازیابی کند و پرونده را با اعلام بازگشت وضعیت عادی بست.